Domain männermütze.de kaufen?
Wir ziehen mit dem Projekt
männermütze.de um.
Sind Sie am Kauf der Domain
männermütze.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain männermütze.de kaufen?
Kennt ihr ein gutes Open-Source-Text-to-Speech (TTS)-Modell?
Ja, ein bekanntes Open-Source-Text-to-Speech-Modell ist Tacotron. Es wurde von Google entwickelt und ist in der Lage, natürliche Sprache zu generieren. Tacotron ist in Python implementiert und kann für verschiedene Anwendungen verwendet werden, wie z.B. Sprachassistenten oder Hörbücher. **
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **

Ähnliche Suchbegriffe für Text-to-Speech TTS
Top-Angebote
Produkte zum Begriff Text-to-Speech TTS:
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Strickmütze LASCANA, Damen, beige, Kunstfaser, leicht glänzend, unifarben, Mützen Strickmütze, Beanie, Wintermütze, Wollmütze, Mütze mit UmschlagMütze mit Pailleten von LASCANA. Aus 40% Polyacryl, 30% Nylon und 30% Polyester., Material: Materialzusammensetzung: Obermaterial: 40% Polyacryl, 30% Nylon, 30% Polyester, Material: Kunstfaser, Farbe: Farbbezeichnung: beige, Optik/Stil: Optik: leicht glänzend, unifarben, Details: Besondere Merkmale: Beanie, Wintermütze, Wollmütze, Mütze mit Umschlag29,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
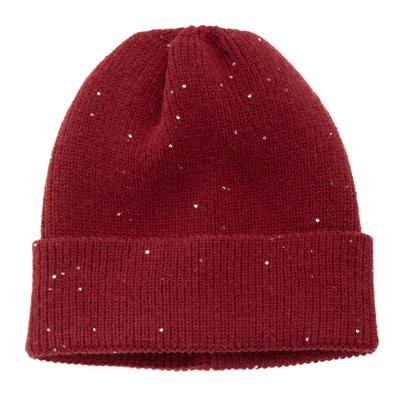
Strickmütze LASCANA, Damen, blau (rot), Kunstfaser, leicht glänzend, unifarben, Mützen Strickmütze, Beanie, Wintermütze, Wollmütze, Mütze mit UmschlagMütze mit Pailleten von LASCANA. Aus 40% Polyacryl, 30% Nylon und 30% Polyester., Material: Materialzusammensetzung: Obermaterial: 40% Polyacryl, 30% Nylon, 30% Polyester, Material: Kunstfaser, Farbe: Farbbezeichnung: rot, Optik/Stil: Optik: leicht...29,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter


-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **


Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
Top-Angebote
Produkte zum Begriff Text-to-Speech TTS:
-
Wintermütze Berkeley Rip Strickmütze Beanie Mütze Wollmütze Unisex 100% KaschmirKlassischer Beanie aus 100% Italian Eco Cashmere Made in Europe - Design in Germany Elegante Wollmütze in Onesize Größe - bei jedem Anlass für Damen und Herren tragbar Kuschelig weich und ohne Kratzen Klassisches, zeitloses Design mit umklappbarem Saum, Rip Struktur und zweilagiger Verarbeitung der Wolle Ein ideales Geschenk aus 100% Kaschmir Produziert innerhalb der EU um konstante Qualität zu einem guten Preis-Leistungs-Verhältnis anbieten zu können Material: 100% Wolle (Kaschmir) Gewicht: 45 g Die Marke Golden Goat präsentiert mit dieser klassischen Rip Struktur Wintermütze aus italienischer Wolle (Kaschmir) genau das Richtige für den anbrechenden Winter. Die Berkeley ist passend für Damen und Herren als Unisex Einheitsgröße ausgelegt. Der Beanie ist sowohl umgeklappt tragbar als auch ohne Umklappen. Das zweilagig verarbeitete Kaschmir verfügt über eine sehr gute Wärmerückhaltung bei geringem Eigengewicht. Die Wollmütze lässt sich unterwegs ideal in der Jackentasche aufbewahren. Zeitloses und klassisches Design aus Deutschland und hergestellt in Europa.12,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
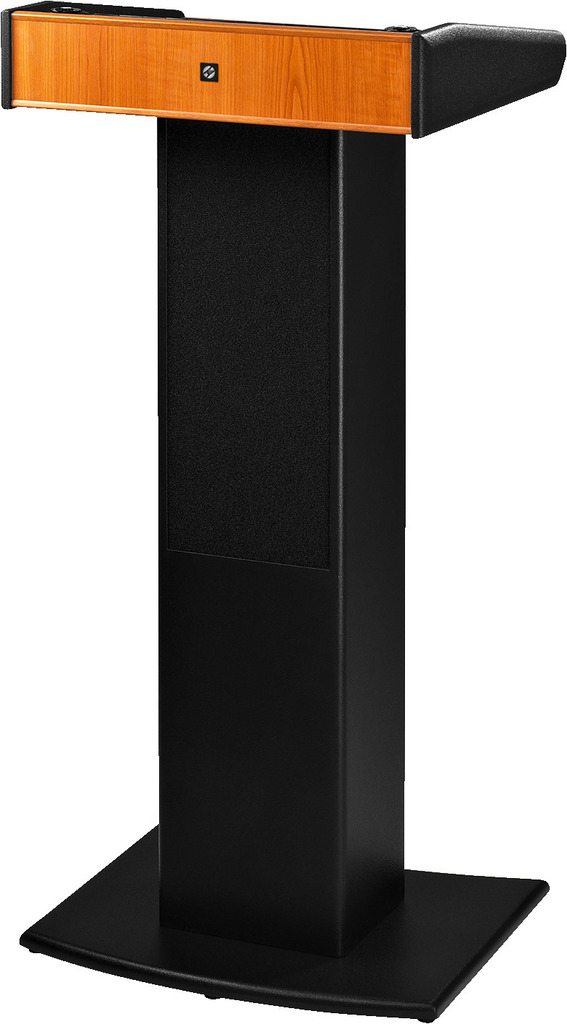
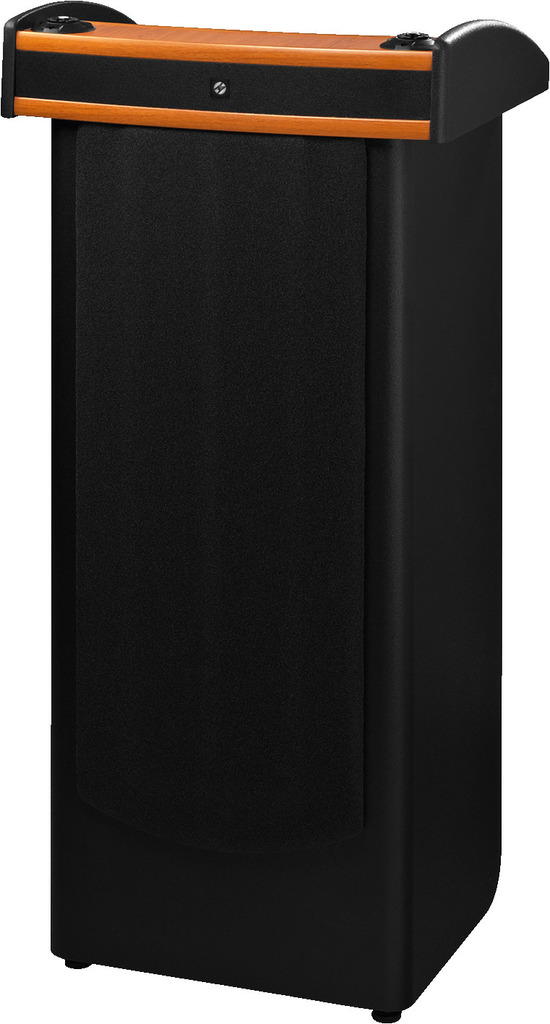
MONACOR SPEECH-104DSPEECH-104D, Eine innovative Qualit�tsl�sung f�r die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualit�t, Lautst�rkef�higkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabh�ngig macht allein das SPEECH-104D aus jeder zu beschallenden Fl�che ein Auditorium. Es passt sich aber selbstverst�ndlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle ben�tigt wird. Die integrierte Verst�rker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Pr�sentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschlie�en - einschalten - fertig.1648,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kennt ihr ein gutes Open-Source-Text-to-Speech (TTS)-Modell?
Ja, ein bekanntes Open-Source-Text-to-Speech-Modell ist Tacotron. Es wurde von Google entwickelt und ist in der Lage, natürliche Sprache zu generieren. Tacotron ist in Python implementiert und kann für verschiedene Anwendungen verwendet werden, wie z.B. Sprachassistenten oder Hörbücher. **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Text-to-Speech TTS
-
Strickmütze LASCANA, Damen, beige, Kunstfaser, leicht glänzend, unifarben, Mützen Strickmütze, Beanie, Wintermütze, Wollmütze, Mütze mit UmschlagMütze mit Pailleten von LASCANA. Aus 40% Polyacryl, 30% Nylon und 30% Polyester., Material: Materialzusammensetzung: Obermaterial: 40% Polyacryl, 30% Nylon, 30% Polyester, Material: Kunstfaser, Farbe: Farbbezeichnung: beige, Optik/Stil: Optik: leicht glänzend, unifarben, Details: Besondere Merkmale: Beanie, Wintermütze, Wollmütze, Mütze mit Umschlag29,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Strickmütze LASCANA, Damen, blau (rot), Kunstfaser, leicht glänzend, unifarben, Mützen Strickmütze, Beanie, Wintermütze, Wollmütze, Mütze mit UmschlagMütze mit Pailleten von LASCANA. Aus 40% Polyacryl, 30% Nylon und 30% Polyester., Material: Materialzusammensetzung: Obermaterial: 40% Polyacryl, 30% Nylon, 30% Polyester, Material: Kunstfaser, Farbe: Farbbezeichnung: rot, Optik/Stil: Optik: leicht...29,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Mthe t.bone Speech 100 M, Steuerzentrale für digitales Konferenzsystem, 2 Gruppen für jeweils bis zu 16 Sprechstellen, Feedbackunterdrückung, USB Aufnahme und Playback (*.mp3, Datenträger bis 32 GB), 4 Diskussionsmodi (3, 6, 9 oder alle Mikrofone können gleichzeitig aktiviert werden), Abstimmungs-Modus, 2x Stereo Rec Out (Cinch), 1x Stereo Out für Soundsystem (Cinch), 1x Stereo In (Cinch), 1x Mic In (XLR mit Phantomspeisung), 1x LAN, Abmessungen: 19" / 2HE, 32cm Einbautiefe, Gewicht 5,5 kg; passendes Case: Art. 496024 (nicht im Lieferumfang enthalten); passender Booster für mehr als 16 Sprechstellen je Linie: Art. 498125 (nicht im Lieferumfang enthalten)469,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.